Всё, что умеет личный кабинет с расшифровкой, доступно и из кода. Через API ваша CRM, бот, скрипт или сценарий в n8n сами отправляют записи на расшифровку и забирают готовый текст: без ручной загрузки файлов и копирования результата. В этом гайде пройдём весь путь от ключа до готовой расшифровки в вашей системе и разберём, где обычно спотыкаются.
Что понадобится
API работает на любом платном тарифе, начиная с «Базового». Отдельной платы за него нет: запросы расходуют те же минуты, что и работа в кабинете. Сначала списываются минуты тарифа, затем докупленные. На бесплатном тарифе ключ создать нельзя, но качество распознавания можно проверить в кабинете на своих файлах.
Из инструментов хватит терминала с cURL или любого языка, который умеет отправлять HTTP-запросы. Все примеры ниже на cURL и Python. Адрес API указан в документации в личном кабинете: в примерах он спрятан в переменную API_BASE.
Шаг 1. Создаём ключ
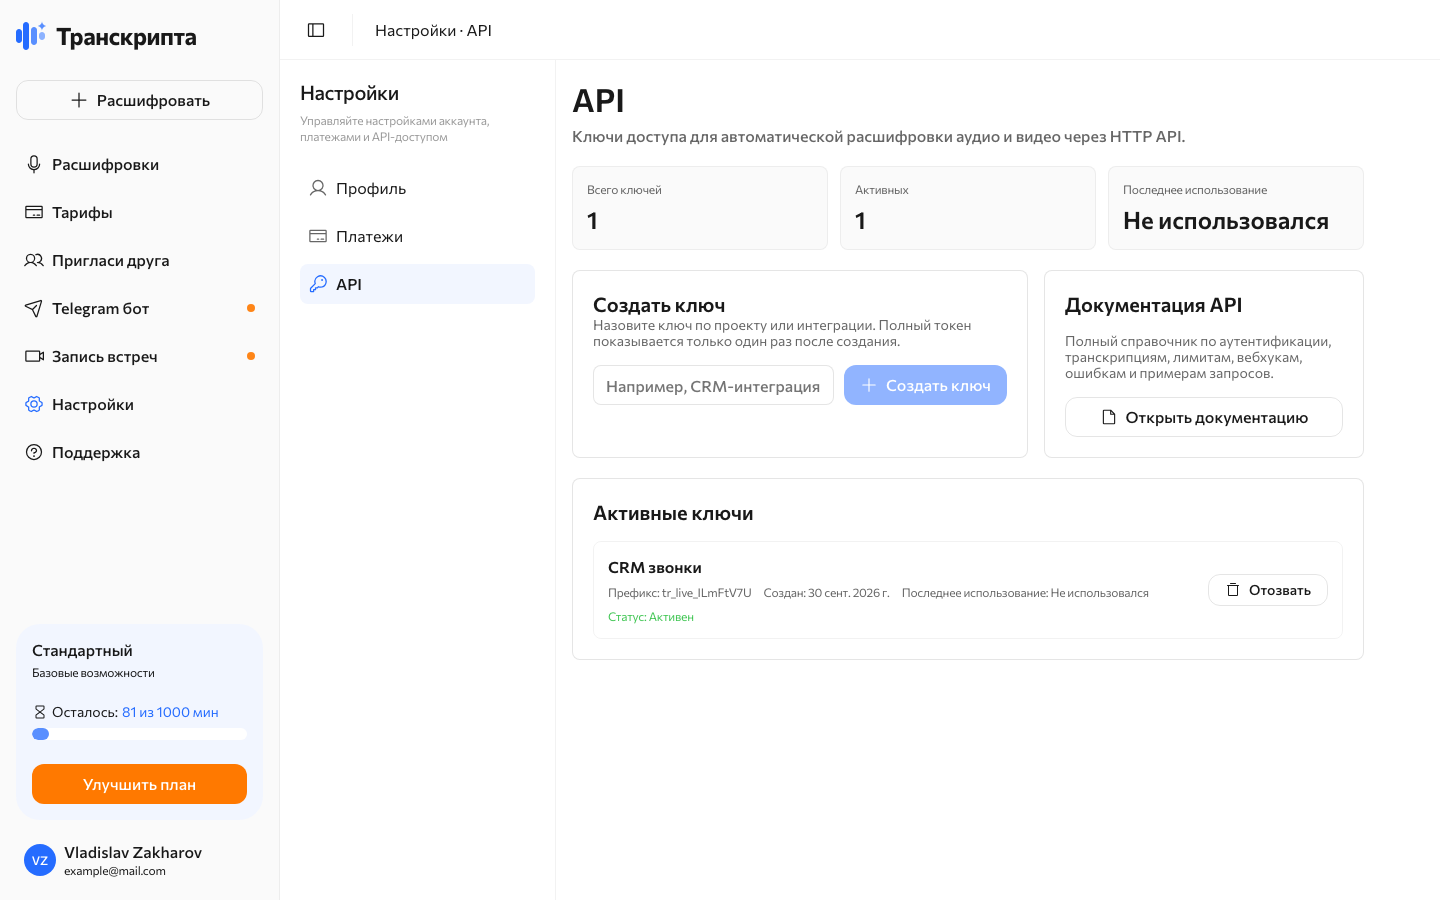
Ключи живут в кабинете: «Настройки» → вкладка «API». Здесь видны все ключи аккаунта, их префиксы и время последнего использования, а кнопка «Открыть документацию» ведёт в полный справочник.
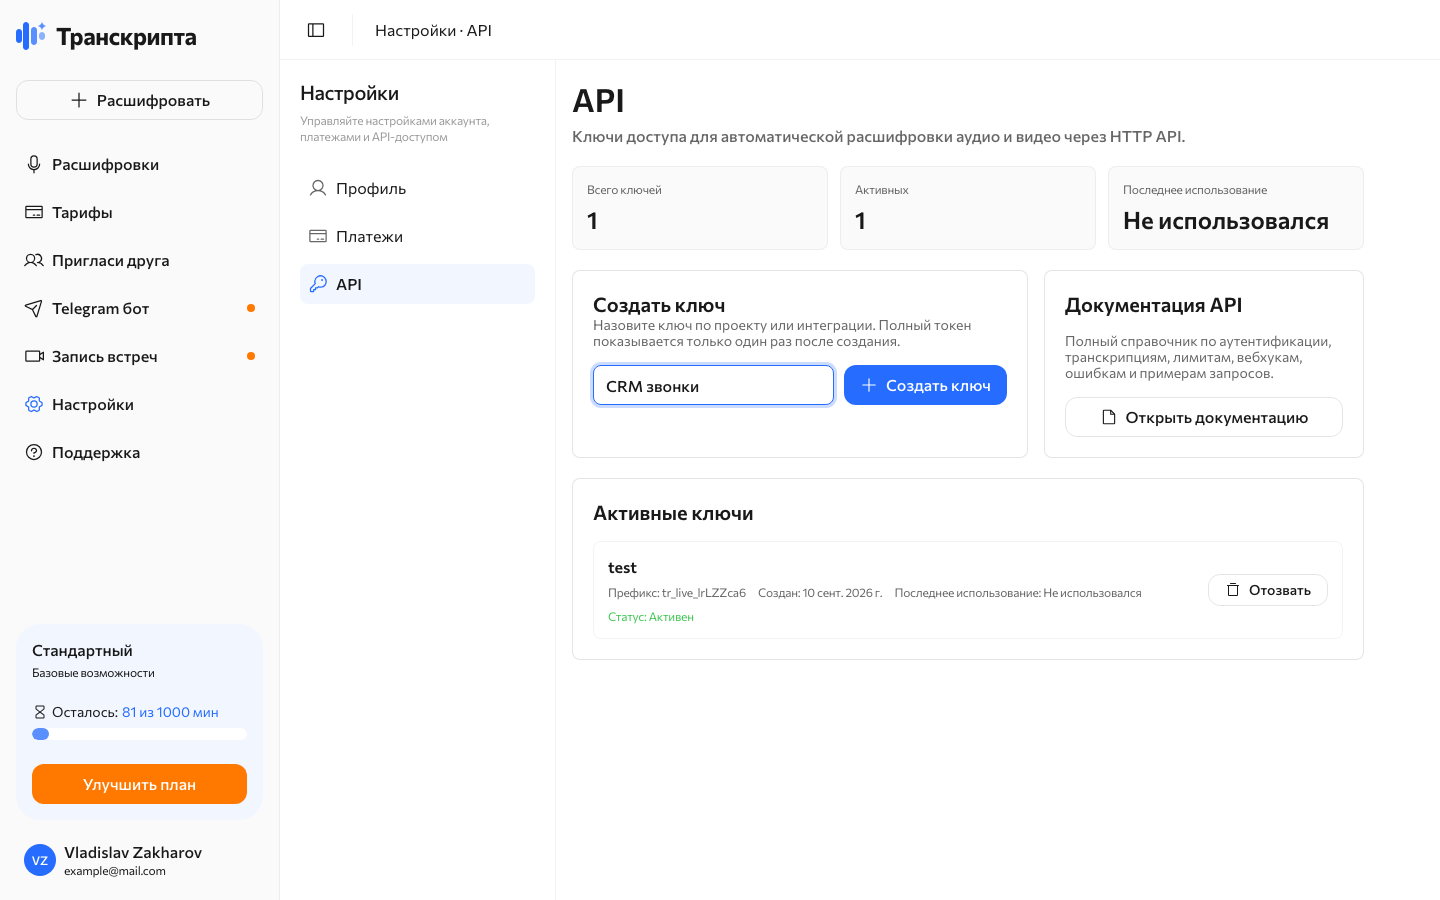
Жмём «Создать ключ» и даём ему понятное название по проекту или интеграции, например «CRM звонки» или «n8n». Когда ключей станет несколько, по названию сразу будет ясно, какой из них отзывать.
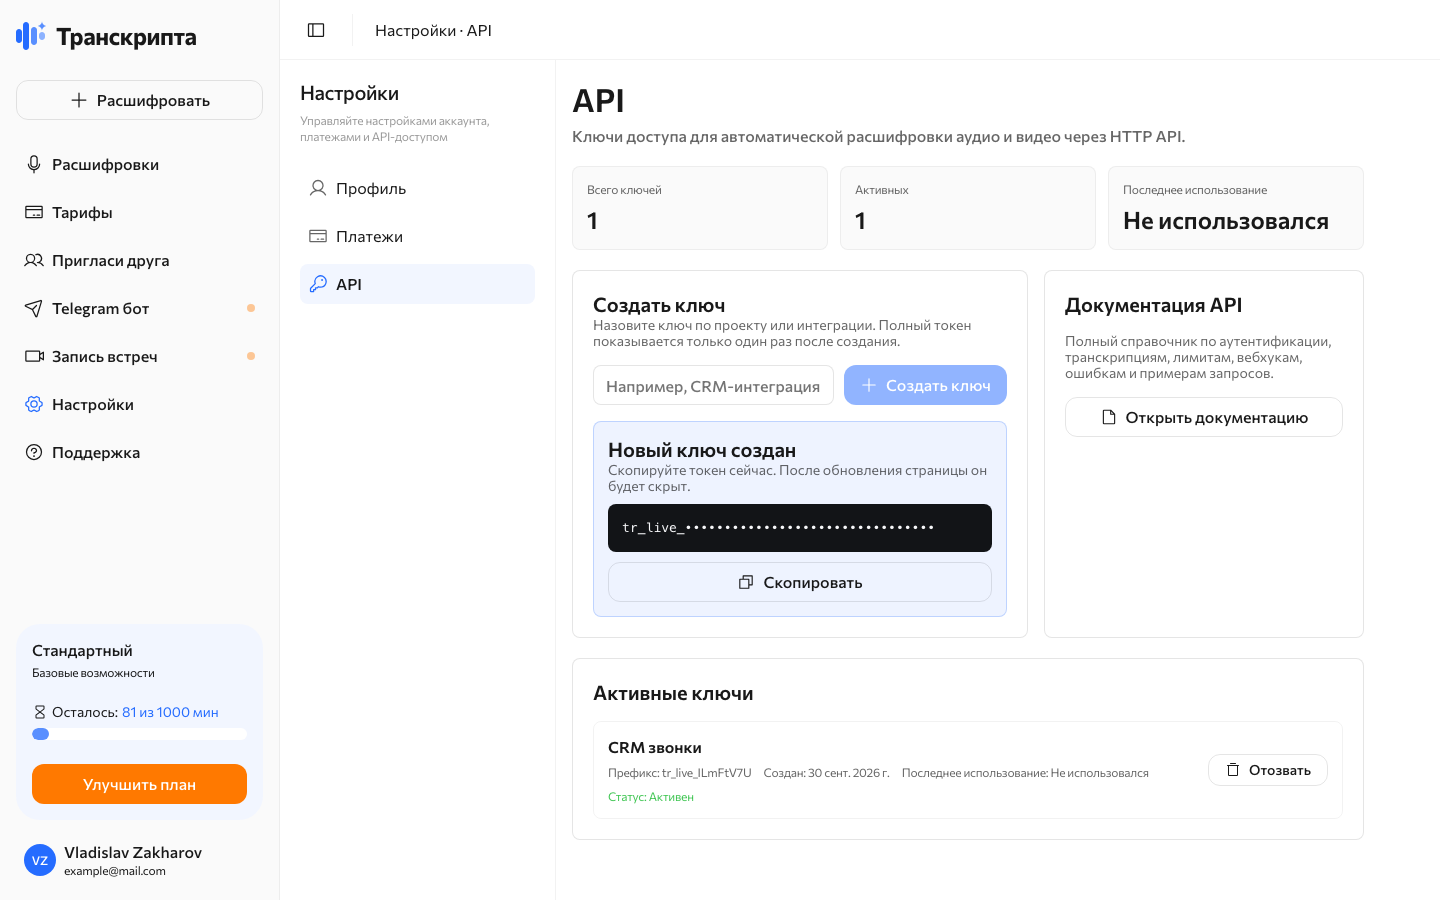
Полный токен показывается один раз, сразу после создания. Скопируйте его и положите в переменную окружения или хранилище секретов на сервере. В браузерный код, мобильное приложение и публичный репозиторий ключ класть нельзя: любой, кто его увидит, сможет тратить ваши минуты. Если ключ всё-таки утёк, отзовите его кнопкой «Отозвать» и создайте новый.
Дальше ключ передаётся в каждом запросе в заголовке:
Authorization: Bearer <ваш ключ>
Шаг 2. Отправляем запись
Задача ставится одним запросом POST /v1/transcriptions. Отдать запись можно двумя способами: файлом или ссылкой.
Файл
Файл уходит как multipart/form-data в поле file. Язык можно не указывать: с language=auto система определит его сама.
curl -X POST "$API_BASE/v1/transcriptions" \
  -H "Authorization: Bearer $TRANSCRIPTA_API_KEY" \
  -H "Idempotency-Key: meeting-2026-09-30" \
  -F "file=@meeting.mp3" \
  -F "language=auto" \
  -F 'metadata={"external_id":"meeting-2026-09-30"}'
Ответ приходит сразу, не дожидаясь расшифровки:
{
  "id": "123",
  "status": "queued",
  "duration_seconds": 1840,
  "request_id": "req_..."
}
Код ответа 202 значит «задача принята». Сохраните id: по нему вы заберёте результат.
Большой файл
В поле file помещается запись до 100 МиБ, на файл больше придёт 413 file_too_large_for_direct_upload. Файлы до 5000 МиБ, как и в кабинете, загружаются по частям через /v1/uploads:
POST /v1/uploadsсfilenameиsize_bytesв JSON. В ответеidзагрузки, размер части (по умолчанию 100 МиБ, можно задать от 5 до 100 МиБ) и число частей.- Для каждой части
POST /v1/uploads/<id>/parts/<номер>/signвыдаёт ссылку, по ней часть отправляется запросомPUT. ЗаголовокContent-Typeне передавайте, иначе подпись не сойдётся: в cURL этоcurl -T part.bin "<ссылка>". Если связь оборвалась,GET /v1/uploads/<id>покажет уже принятые части. POST /v1/uploads/<id>/completeсобирает файл и определяет длительность. Минуты на этом шаге ещё не списываются.POST /v1/transcriptionsс JSON{"upload_id": "upl_..."}и теми жеlanguage,num_speakersиmetadataставит задачу, дальше всё как с обычным файлом.
Ссылка
Если запись лежит на YouTube, Rutube или VK Видео, скачивать её не нужно. Передайте ссылку в JSON, и сервер сам вытянет звук:
curl -X POST "$API_BASE/v1/transcriptions" \
  -H "Authorization: Bearer $TRANSCRIPTA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: lecture-42" \
  -d '{"source_url": "https://www.youtube.com/watch?v=...", "language": "auto"}'
Другие адреса в source_url пока не принимаются. Запись из CRM или облачного диска скачайте и отправьте файлом. Ролик должен быть публичным, то есть открываться по ссылке у любого.
Два полезных параметра
Idempotency-Key защищает от дублей. Если запрос оборвался по таймауту и вы повторили его с тем же ключом, вторая задача не создастся, а минуты не спишутся дважды. Подойдёт любая строка до 160 символов, например ID звонка или имя файла с датой.
metadata — ваши данные, которые сервис хранит вместе с задачей и возвращает в статусе, списке и результате, а также в каждом вебхуке. Удобнее всего положить туда external_id — ID сделки, звонка или урока в вашей системе. Тогда результат не придётся сопоставлять с источником вручную. Размер metadata в виде JSON — до 16 КиБ, больше вернёт 400 invalid_metadata.
Ещё можно передать num_speakers, если число участников известно заранее. Это подсказка для разметки спикеров, а не обязательный параметр.
Шаг 3. Узнаём о готовности
Расшифровка идёт асинхронно: час записи обычно обрабатывается за несколько минут. Узнать о готовности можно двумя путями.
Вебхук
Самый удобный вариант: сервис сам постучится на ваш HTTPS-адрес, когда задача изменит статус. Адрес регистрируется один раз:
curl -X POST "$API_BASE/v1/webhook-endpoints" \
  -H "Authorization: Bearer $TRANSCRIPTA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com/webhooks/transcription", "description": "CRM", "events": ["transcription.completed", "transcription.failed"]}'
В ответе придёт secret вида whsec_.... Он тоже показывается один раз, сохраните его рядом с ключом. Всего событий пять: transcription.queued, transcription.processing, transcription.completed, transcription.failed и transcription.cancelled. Для большинства интеграций хватает двух последних из списка выше: «готово» и «ошибка».
Сам вебхук выглядит так:
{
  "id": "evt_...",
  "type": "transcription.completed",
  "created_at": "2026-09-30T10:00:00.000Z",
  "data": {
    "transcription_id": 123,
    "status": "done",
    "filename": "meeting.mp3",
    "duration_seconds": 1840,
    "error_reason": null,
    "metadata": { "external_id": "meeting-2026-09-30" }
  }
}
Текста расшифровки в нём нет: это сигнал «пора забирать». Зато в data.metadata лежат ваши metadata, так что по external_id сразу видно, к какой записи относится событие. За самим результатом идём отдельным запросом из шага 4.
Прежде чем верить вебхуку, проверьте подпись. Она приходит в заголовке Transcripta-Signature в формате t=<время>,v1=<подпись>, где подпись — это HMAC-SHA256 от строки «время, точка, сырое тело запроса», посчитанный вашим секретом. Заголовки называются одинаково на всех доменах сервиса. Пример на Python:
import hashlib
import hmac
import time

def is_valid(signature_header: str, raw_body: bytes, secret: str) -> bool:
    parts = dict(item.split("=", 1) for item in signature_header.split(","))
    timestamp, received = parts["t"], parts["v1"]
    if abs(time.time() - int(timestamp)) > 300:
        return False  # слишком старое событие
    payload = timestamp.encode() + b"." + raw_body
    expected = hmac.new(secret.encode(), payload, hashlib.sha256).hexdigest()
    return hmac.compare_digest(expected, received)
Берите именно сырое тело запроса, до разбора JSON: после повторной сериализации подпись не сойдётся. Успехом считается любой ответ 2xx. Если ваш сервер не ответил или вернул ошибку, доставка повторится с тем же id события: всего до восьми попыток с нарастающей паузой, от минуты до трёх суток. Поэтому обработчик должен спокойно переносить дубли. Историю доставок показывает GET /v1/webhook-events, а любое событие можно отправить заново через POST /v1/webhook-events/:eventId/replay.
Опрос статуса
Если принимать входящие запросы негде, например в простом скрипте, опрашивайте статус задачи:
curl "$API_BASE/v1/transcriptions/123" \
  -H "Authorization: Bearer $TRANSCRIPTA_API_KEY"
Спрашивайте не чаще раза в 10–30 секунд: на ключ действует лимит в 120 запросов в минуту. Когда status станет done, результат готов.
Шаг 4. Забираем результат
curl "$API_BASE/v1/transcriptions/123/result" \
  -H "Authorization: Bearer $TRANSCRIPTA_API_KEY"
{
  "data": {
    "id": "123",
    "status": "done",
    "language": "ru",
    "duration_seconds": 1840,
    "text": "Добрый день! Давайте сверим план на квартал. ...",
    "segments": [
      {
        "start": 0.0,
        "end": 4.2,
        "speaker": "Speaker 1",
        "text": "Добрый день! Давайте сверим план на квартал."
      },
      {
        "start": 4.6,
        "end": 9.8,
        "speaker": "Speaker 2",
        "text": "Да, по продажам идём с опережением на 12%."
      }
    ],
    "participants": "...",
    "summary": "Сверили квартальный план: продажи опережают план на 12%...",
    "tags": "...",
    "metadata": { "external_id": "meeting-2026-09-30" }
  },
  "request_id": "req_..."
}
Что здесь лежит:
text— вся расшифровка одним текстом, с пунктуацией;segments— реплики с началом и концом в секундах и меткой спикера. Из них собираются субтитры, диалог в карточке сделки или поиск по записи с переходом к нужной секунде;summary,tagsиparticipants— краткий пересказ, теги и участники. Их не нужно отдельно просить у нейросети, они приходят в том же ответе;metadata— то, что вы передали при создании задачи.
Если задача ещё в работе, этот запрос вернёт код 202 с кратким статусом. Если расшифровка не удалась, придёт 422 с причиной.
Вот так, например, выглядит в Python весь цикл без вебхука:
import os
import time
import requests

API_BASE = os.environ["API_BASE"]
HEADERS = {"Authorization": f"Bearer {os.environ['TRANSCRIPTA_API_KEY']}"}

with open("meeting.mp3", "rb") as f:
    task = requests.post(
        f"{API_BASE}/v1/transcriptions",
        headers={**HEADERS, "Idempotency-Key": "meeting-2026-09-30"},
        files={"file": f},
        data={"language": "auto"},
    ).json()

while True:
    r = requests.get(f"{API_BASE}/v1/transcriptions/{task['id']}/result", headers=HEADERS)
    if r.status_code == 200:
        result = r.json()["data"]
        break
    if r.status_code == 422:
        raise RuntimeError(r.json())
    time.sleep(15)

for s in result["segments"]:
    print(f"[{s['start']:.0f}s] {s['speaker']}: {s['text']}")
print("Итог:", result["summary"])
Лимиты, ошибки и минуты
Лимиты считаются на ключ:
| Что | Лимит |
|---|---|
Все запросы к /v1/* | 120 в минуту |
Создание задач POST /v1/transcriptions | 20 в минуту |
Прямая загрузка файла в поле file | до 100 МиБ |
Большой файл через /v1/uploads | до 5000 МиБ, части по 5–100 МиБ |
metadata | до 16 КиБ |
Idempotency-Key | до 160 символов |
В каждом ответе приходят заголовки RateLimit-Remaining и RateLimit-Reset: по ним клиент может притормозить заранее. Если лимит всё же исчерпан, придёт код 429 и заголовок Retry-After — сколько секунд подождать.
Ошибки всегда приходят в одном формате:
{
  "error": {
    "code": "insufficient_minutes",
    "message": "...",
    "request_id": "req_..."
  }
}
Чаще всего встречаются:
- 401
invalid_api_key— ключ не передан, опечатка или ключ отозван; - 402
insufficient_minutes— закончились минуты, пора продлить тариф или докупить минуты; - 400
unsupported_source_domain— ссылка не с YouTube, Rutube или VK Видео; - 413
file_too_large_for_direct_upload— файл больше лимита прямой загрузки; - 429
rate_limit_exceeded— превышен лимит запросов.
Повторять имеет смысл только 429 и ошибки 5xx, причём с тем же Idempotency-Key. Остальные 4xx при повторе не пройдут: сначала исправьте запрос. request_id из ответа пригодится поддержке, чтобы быстро найти ваш запрос.
Остаток минут и статистику API по дням возвращает GET /v1/usage?days=30. Удобно вывести его в свой мониторинг, чтобы интеграция не встала посреди месяца. А если задача поставлена по ошибке, её можно отменить через POST /v1/transcriptions/:id/cancel, пока она не готова, и минуты вернутся на баланс.
Проверка без кода: Postman
Хочется сначала пощупать API руками? Подойдёт Postman или любой похожий клиент:
- Создайте запрос
POSTна адресAPI_BASE/v1/transcriptions, подставив адрес из документации. - На вкладке Authorization выберите тип Bearer Token и вставьте ключ.
- На вкладке Body выберите form-data, добавьте поле
fileс типом File и выберите запись. - Нажмите Send, скопируйте
idиз ответа и через пару минут сделайтеGETна/v1/transcriptions/<id>/resultс тем же ключом.
Ключ лучше хранить в переменных окружения Postman, а не прямо в запросе. Иначе он уедет вместе с экспортом коллекции.
Документация и помощь ИИ-агента
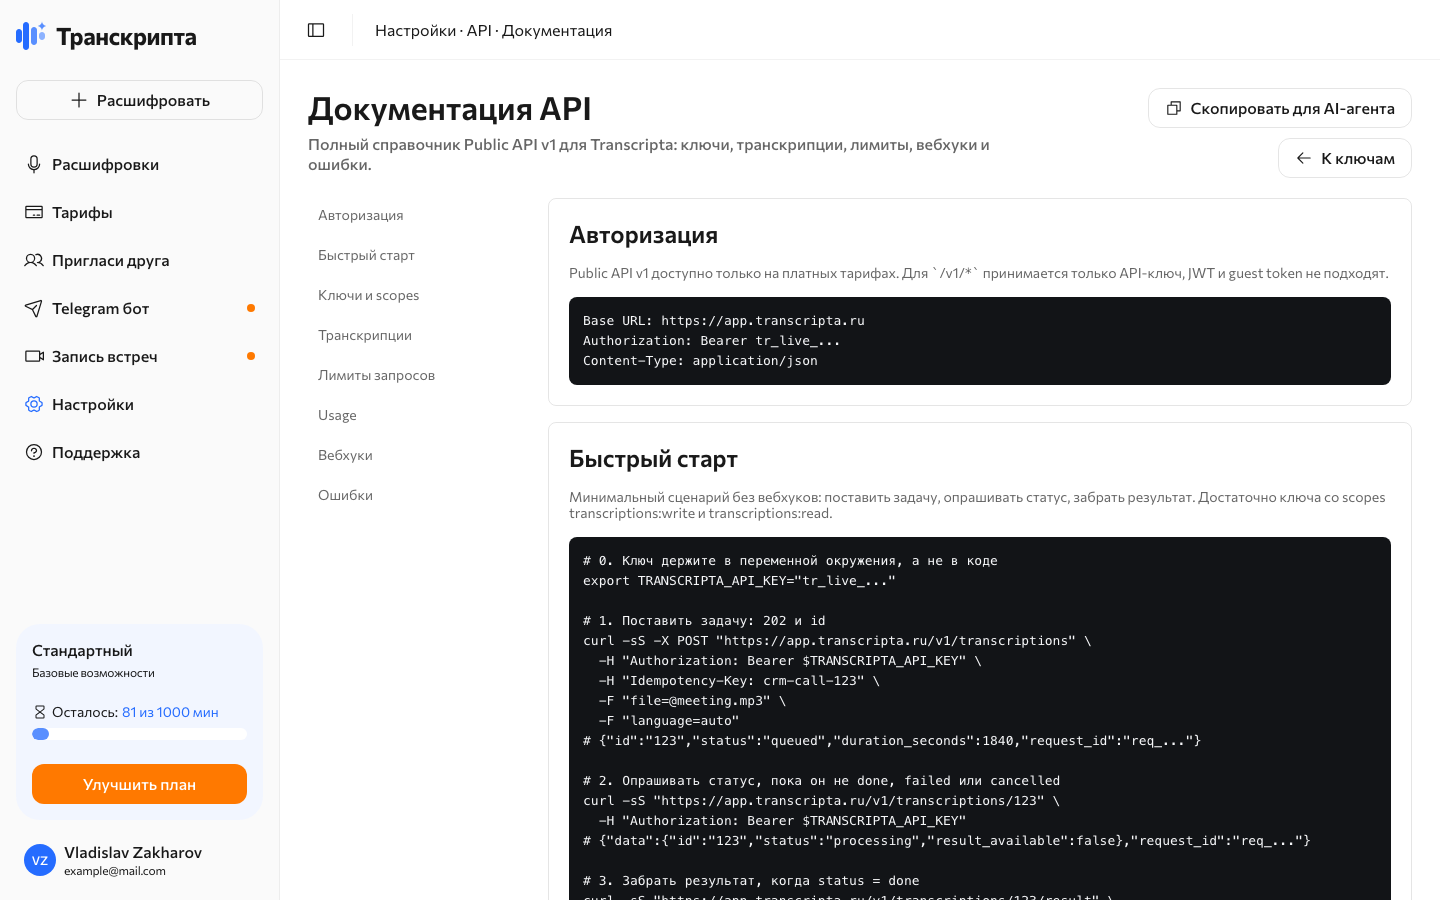
Полный справочник лежит в кабинете, в разделе API по кнопке «Открыть документацию». Там все методы, поля ответов, события вебхуков, коды ошибок и примеры запросов. А кнопка «Скопировать для AI-агента» кладёт в буфер всю документацию одним текстом. Вставьте её в Cursor, Claude или ChatGPT, опишите свою задачу, например «забирай записи звонков из нашей CRM и пиши итог в карточку сделки», и ассистент напишет интеграцию под ваш стек.
Что дальше
Готовые сценарии со схемами и примерами запросов собраны на отдельных страницах:
- API транскрибации — все возможности и сокращённый справочник;
- Расшифровка звонков из CRM и телефонии — схема для amoCRM, Битрикс24 и IP-телефонии;
- Транскрибация в n8n и Python — рецепт на нодах HTTP Request и Webhook.
Весь путь занимает четыре шага: ключ в кабинете, POST с файлом или ссылкой, вебхук или опрос статуса и GET результата. Дальше текст, реплики по спикерам и саммари уже живут в вашей системе. Если что-то не заводится, напишите в поддержку и приложите request_id из ответа: так ваш запрос найдут быстрее всего.